Типовой проект ИИ-кластера для корпоративного инференса: 8 узлов NVIDIA HGX B300, фабрика InfiniBand XDR 800G на Quantum-X800 Q3400 и ведомость оптики
Самый частый запрос, с которым к нам в ITPOD приходят партнёры-интеграторы в 2026 году, корпоративный ИИ: заказчику нужен собственный кластер под ассистентов, RAG и кодовые помощники, без облака и без передачи данных наружу. Звучит такой запрос почти всегда как выбор compute-узлов: какие GPU, сколько памяти. Но узлы - половина проекта. Вторая половина - вычислительная фабрика, которая связывает GPU между собой: топология, коммутаторы и оптика. Её часто считают в последний момент, а ошибки в ней всплывают уже на монтаже.
Ниже - типовой проект небольшого ИИ-кластера, каким мы в ITPOD его собираем для партнёров: 8 узлов NVIDIA HGX B300, 64 GPU Blackwell Ultra, фабрика InfiniBand XDR 800G на коммутаторах NVIDIA Quantum-X800 Q3400-RA, разбор вариантов коммутаторов фабрики и полная ведомость оптики по парт-номерам, с проверкой сходимости, которую можно перепроверить руками. Спойлер: оптика во всех вариантах одна и та же, поэтому выбор сводится к одному вопросу — один коммутатор Q3400 или два, и ниже он решается на числах, а не на ощущениях.
Коротко, если нужен только ответ:
- Задача: продуктивный инференс больших MoE-моделей (Kimi K3, DeepSeek-V4-Pro) на 8 узлах NVIDIA HGX B300 — 64 GPU, 18,4 ТБ HBM, 64 порта 800G.
- Фабрика: одноуровневая InfiniBand XDR на NVIDIA Quantum-X800 Q3400-RA, без spine и без межкоммутаторных линков (ISL). Любой GPU достаёт любой за один хоп.
- Оптика одинакова во всех сценариях без ISL: 96 трансиверов (32 твин-портовых ITPOD-OSFP-FT-16DR8 на коммутатор + 64 одиночных ITPOD-OSFP-RHS-800DR4 на узлы) и 64 патч-корда MTP-12. Выбор сводится к числу коммутаторов.
- Стартовый сценарий - один Q3400: ноль замедления, одна подсеть, потолок 18 узлов; обновление прошивки отказ шасси останавливают всю фабрику.
- Рекомендованный сценарий для 24×7 — пара Q3400 без ISL (rail 4+4): та же оптика, отказ шасси переживается на половине полосы, прошивка по очереди, потолок 36 узлов; цена — две подсети и 6,9 % ко времени фазы all-to-all.
- ISL инференсу не нужны: Fat Tree на 32 ISL добавляет 32 модуля и 32 корда и снижает потолок пары до 18 узлов. Это запас под дообучение и any-to-any, а не страховка по умолчанию.
Ключевые числа проекта - всё, на что опирается статья, в одной таблице:
| Ключевое число | Значение |
|---|---|
| Узлы / GPU / HBM кластера | 8 × HGX B300 / 64 × B300 (288 ГБ) / 18,4 ТБ |
| Порты 800G от узлов | 64 (8 × ConnectX-8 на узел, 6,4 Тбит/с на узел) |
| Коммутатор | NVIDIA Quantum-X800 Q3400-RA: 144 порта 800G, 72 разъёма OSFP под данные, 4U |
| Трансиверов / патч-кордов (любой сценарий без ISL) | 96 / 64 |
| Замедление all-to-all: один Q3400 / пара без ISL | 0 % / 6,9 % (расчёт по формуле Rail-only, MIT) |
| InfiniBand-подсетей: один Q3400 / пара без ISL | 1 / 2 |
| Потолок узлов без spine: один Q3400 / пара без ISL / пара с ISL | 18 / 36 / 18 |
| Тепловыделение твин-портового модуля 1.6T | до 33,5 Вт; finned top для коммутатора, flat top (RHS) для сетевой карты |
1. Задача: корпоративный инференс MoE-моделей Kimi K3 и DeepSeek-V4-Pro на 64 GPU HGX B300
Условия задачи типовые для корпоративного ИИ 2026 года. Кластер обслуживает большие открытые MoE-модели. Kimi K3 несёт 2,8 трлн параметров, на токен активируется 16 из 896 экспертов, в FP4 веса занимают около 1,4 ТБ. DeepSeek-V4-Pro - 1,6 трлн параметров, 49 млрд активных, контекст 1 млн токенов, в FP8 около 1,6 ТБ весов. Нагрузка - корпоративные ассистенты, RAG-контур, кодовые помощники. Обучение моделей такого размера идёт на кластерах в сотни узлов и в задачу не входит.
Отсутствие обучения требований к полосе не смягчает. Инференс больших MoE даёт три источника межузлового трафика: all-to-all Expert Parallelism на каждом MoE-слое каждого прохода, передача KV-кэша между prefill- и decode-воркерами и интерактивные SLA, где пользователь видит хвостовые задержки фабрики как подтормаживание ассистента. Поэтому узел сохраняет все восемь портов 800G - по одному адаптеру NVIDIA ConnectX-8 на каждый GPU, 6,4 Тбит/с на узел.
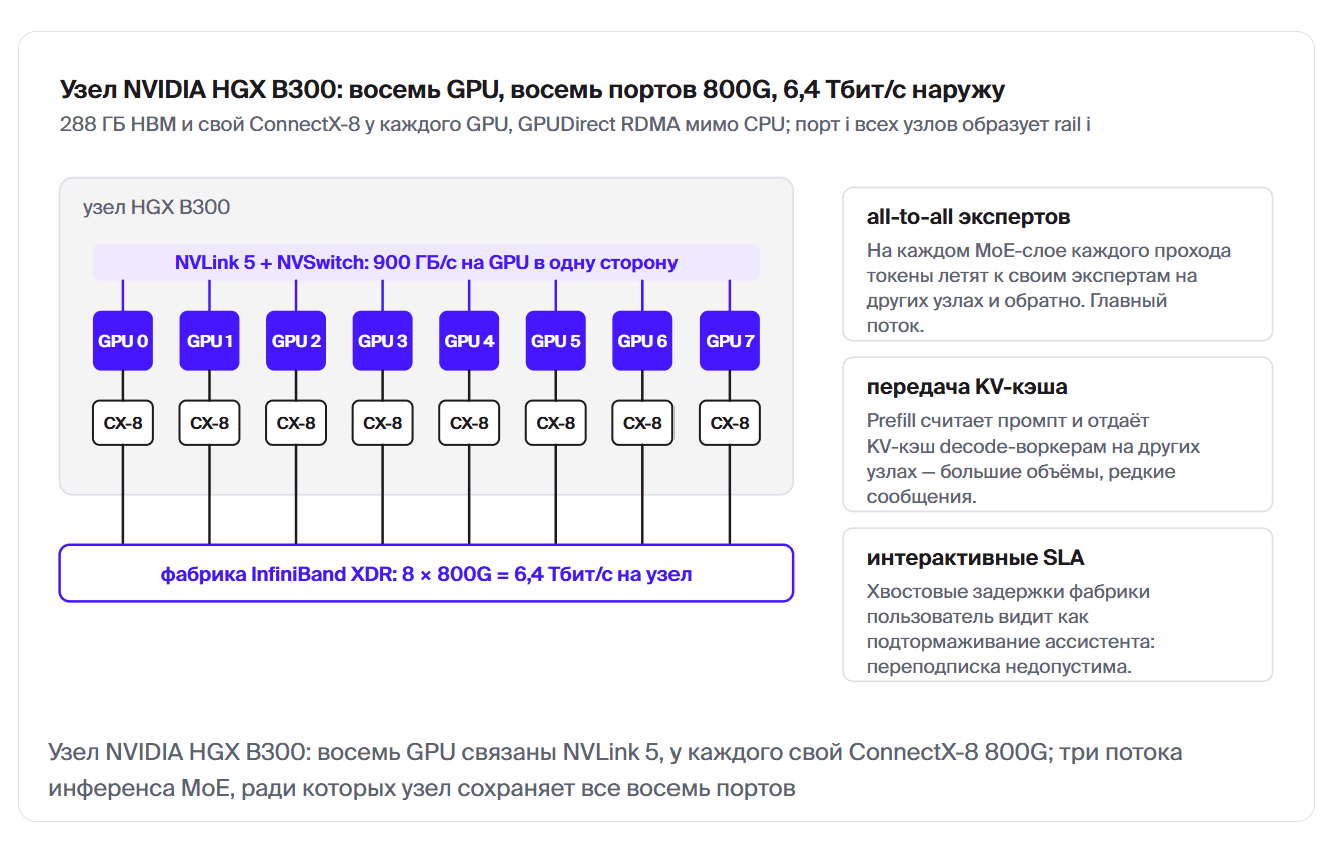
Выбор узлов в таких проектах проходит быстро: под большие MoE нужны восемь GPU с максимальной HBM на узел и по сетевому адаптеру на каждый GPU, а дальше решают память и делимость экспертов, и это арифметика раздела 2. Развилка, на которой проект действительно буксует, как собрать эти 64 порта 800G в фабрику: в один коммутатор или в два, с межкоммутаторными линками или без, и с какой оптикой.
Шесть терминов, без которых дальше не разобраться:
MoE
модель со «смесью экспертов»: вместо одной большой сети - набор специализированных, и на каждый токен роутер включает лишь несколько из них. У Kimi K3 это 16 экспертов из 896.
Expert Parallelism
раскладка экспертов по разным ускорителям. Кросс-узловой вариант NVIDIA называет WideEP: эксперты распределены по всему кластеру, и это освобождает память под KV-кэш.
all-to-all
обмен «каждый с каждым»: на каждом слое токены разлетаются к своим экспертам на других узлах и возвращаются обратно. Главный источник межузлового трафика на инференсе MoE.
KV-кэш
рабочая память диалога: то, что модель уже посчитала по промпту и перечитывает на каждом новом токене.
rail
«полоса» фабрики: порты с одинаковым номером на всех узлах кластера. Порты одного rail заводятся в один коммутатор, чтобы GPU разных узлов обменивались за один хоп. Развёрнуто — в разделе 3.
prefill и decode
две фазы обработки запроса. Prefill за один проход считает весь промпт и строит KV-кэш, decode генерирует ответ по одному токену. Их часто разносят на разные группы ускорителей, и тогда KV-кэш передаётся между ними по сети.
2. Почему 8 узлов HGX B300 это рабочий размер под инференс больших MoE
Восемь узлов выбраны не как круглое число. На этом размере сходятся три вещи, и каждая проверяется арифметикой.
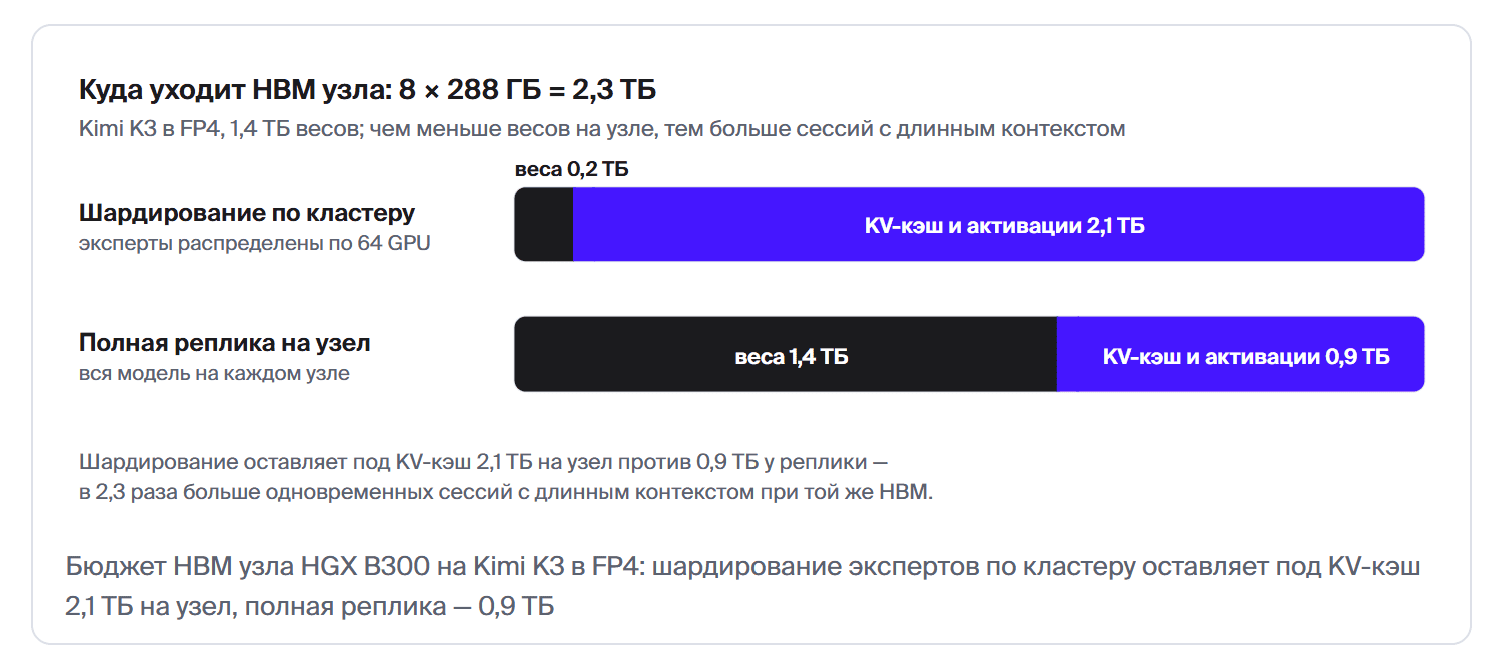
Память уходит под KV-кэш, а не под веса. 64 ускорителя по 288 ГБ дают 18,4 ТБ HBM. Когда эксперты шардированы по всему кластеру, веса Kimi K3 в FP4 занимают 22 ГБ на ускоритель, DeepSeek-V4-Pro в FP8 - 25 ГБ. Остальные 263 ГБ на ускоритель свободны под KV-кэш и активации, а именно ёмкость KV определяет, сколько одновременных сессий с длинным контекстом кластер обслужит. Полная реплика модели на узел оставила бы под KV 0,9 ТБ на узел вместо 2,1 ТБ.
Эксперты и параллелизм делятся без остатка. 896 экспертов Kimi K3 на 64 ускорителя — ровно 14 на каждый. Число ускорителей - степень двойки, поэтому тензорный параллелизм внутри узла на 8 и экспертный по кластеру на 64 раскладываются без дробей и простаивающих ускорителей.
Фабрика остаётся одноуровневой. 64 порта 800G влезают в один коммутатор, любой ускоритель достаёт любой за один хоп, а второй уровень коммутации со своей оптикой и своими деньгами не нужен вовсе.
| Что считаем | Значение | Что из этого следует |
|---|---|---|
| HBM кластера | 64 × 288 ГБ = 18,4 ТБ | обе целевые модели живут одновременно |
| Веса Kimi K3 в FP4 на ускоритель при шардировании | 1,4 ТБ ÷ 64 = 22 ГБ | под KV-кэш свободно 263 ГБ |
| Экспертов Kimi K3 на ускоритель | 896 ÷ 64 = 14 | раскладка без остатка и без простоя |
| Свободно под KV на узел: шардирование против реплики | 2,1 ТБ против 0,9 ТБ | больше сессий с длинным контекстом |
| Портов 800G от узлов | 64 | помещаются в один коммутатор |
3. Как разложить 64 порта 800G по коммутаторам: один Q3400 или пара без ISL
Коммутатор фабрики в этом проекте один - NVIDIA Quantum-X800 Q3400-RA. Вопрос не в модели, а в том, сколько коммутаторов ставить и как разложить по ним 64 порта узлов. Ответов два, и у каждого своя цена.
Что за коммутатор. Q3400-RA - один ASIC, 144 порта 800G в одной коммутационной плоскости, высота 4U. Портов вдвое больше, чем разъёмов OSFP: каждый из 72 разъёмов под данные несёт твин-портовый модуль 1.6T и обслуживает два линка. Отсюда самая частая ошибка спецификации оптики - модули, посчитанные по портам, а не по разъёмам; она регулярно доживает до монтажа.
Что такое rail. В узле HGX у каждого GPU свой ConnectX-8 на 800G: восемь GPU — восемь портов наружу. Порты с одинаковым номером на всех узлах образуют rail: rail 3 — это третьи порты всех восьми узлов. Порты одного rail заводятся в один коммутатор, чтобы GPU разных узлов обменивались за один хоп; это и есть каноническая rail-optimized раскладка NVIDIA.
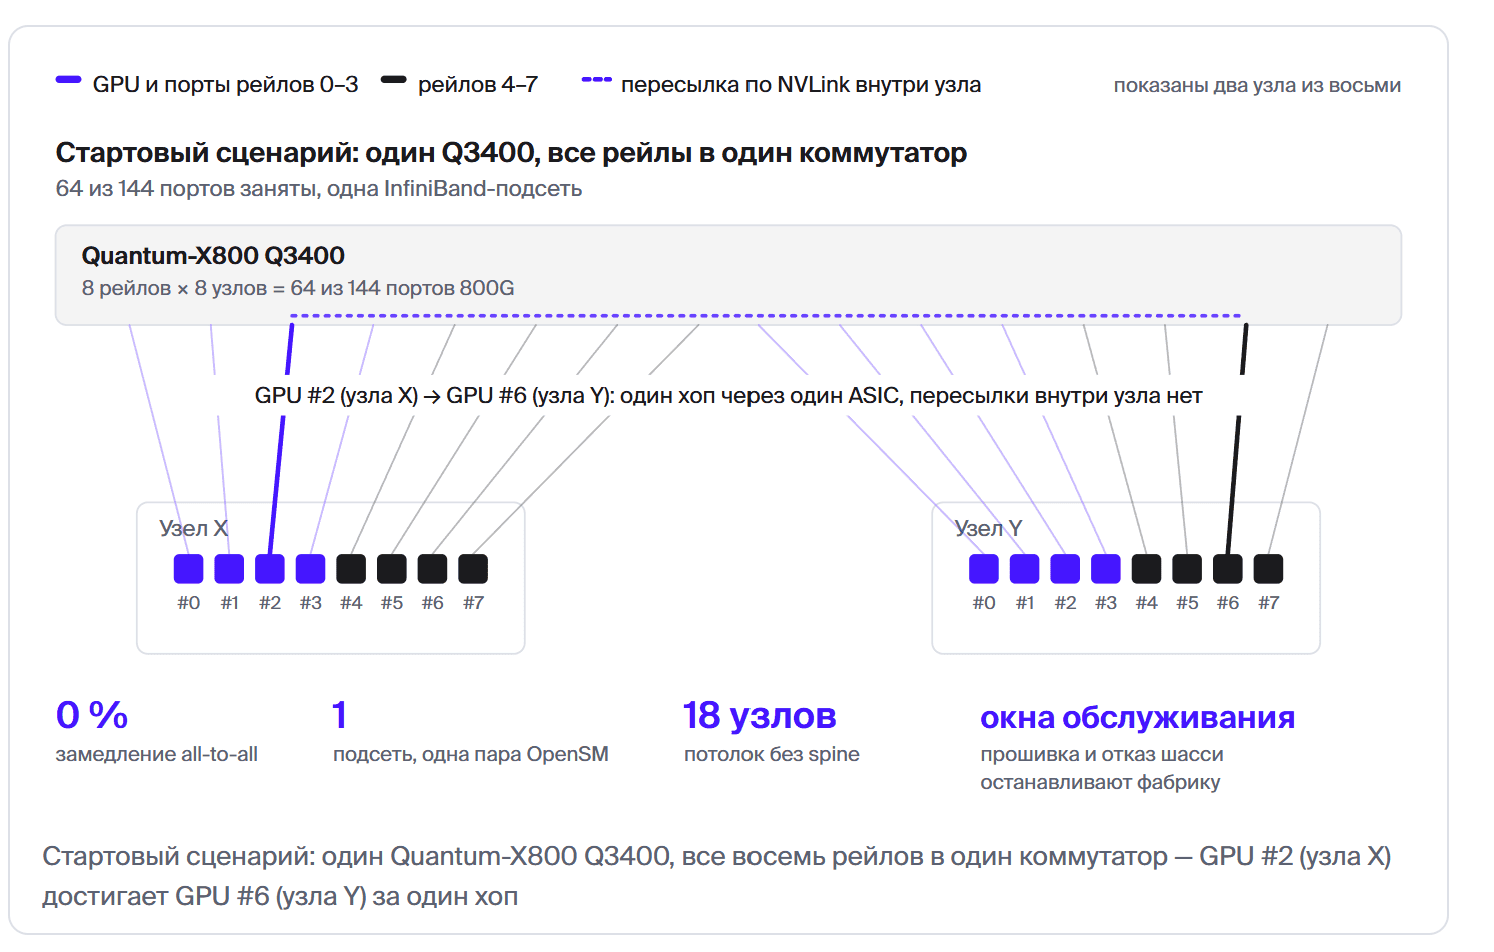
Стартовая раскладка: все рейлы в один коммутатор. Один Q3400 забирает все 64 порта — 8 рейлов × 8 узлов из 144. Любая пара GPU видит друг друга через один ASIC, подсеть одна, пересылки внутри узла нет. Ограничение единственное: коммутатор один, поэтому обновление прошивки и отказ шасси останавливают всю фабрику.
Рекомендованная раскладка: пара Q3400 без ISL, rail 4+4. Рейлы 0-3 всех узлов идут в первый коммутатор, рейлы 4-7 - во второй, между коммутаторами кабелей нет. Оптика не меняется ни на модуль, а фабрика переживает отказ шасси и обновляется по очереди. Платить приходится двумя вещами: это две InfiniBand-подсети, и половине адресатов вне узла (28 из 56) нужна пересылка внутри узла - данные сначала едут по NVLink до GPU, чей порт смотрит в нужный коммутатор, и только затем уходят тем же одним хопом. В NCCL эту пересылку делает механизм PXN.
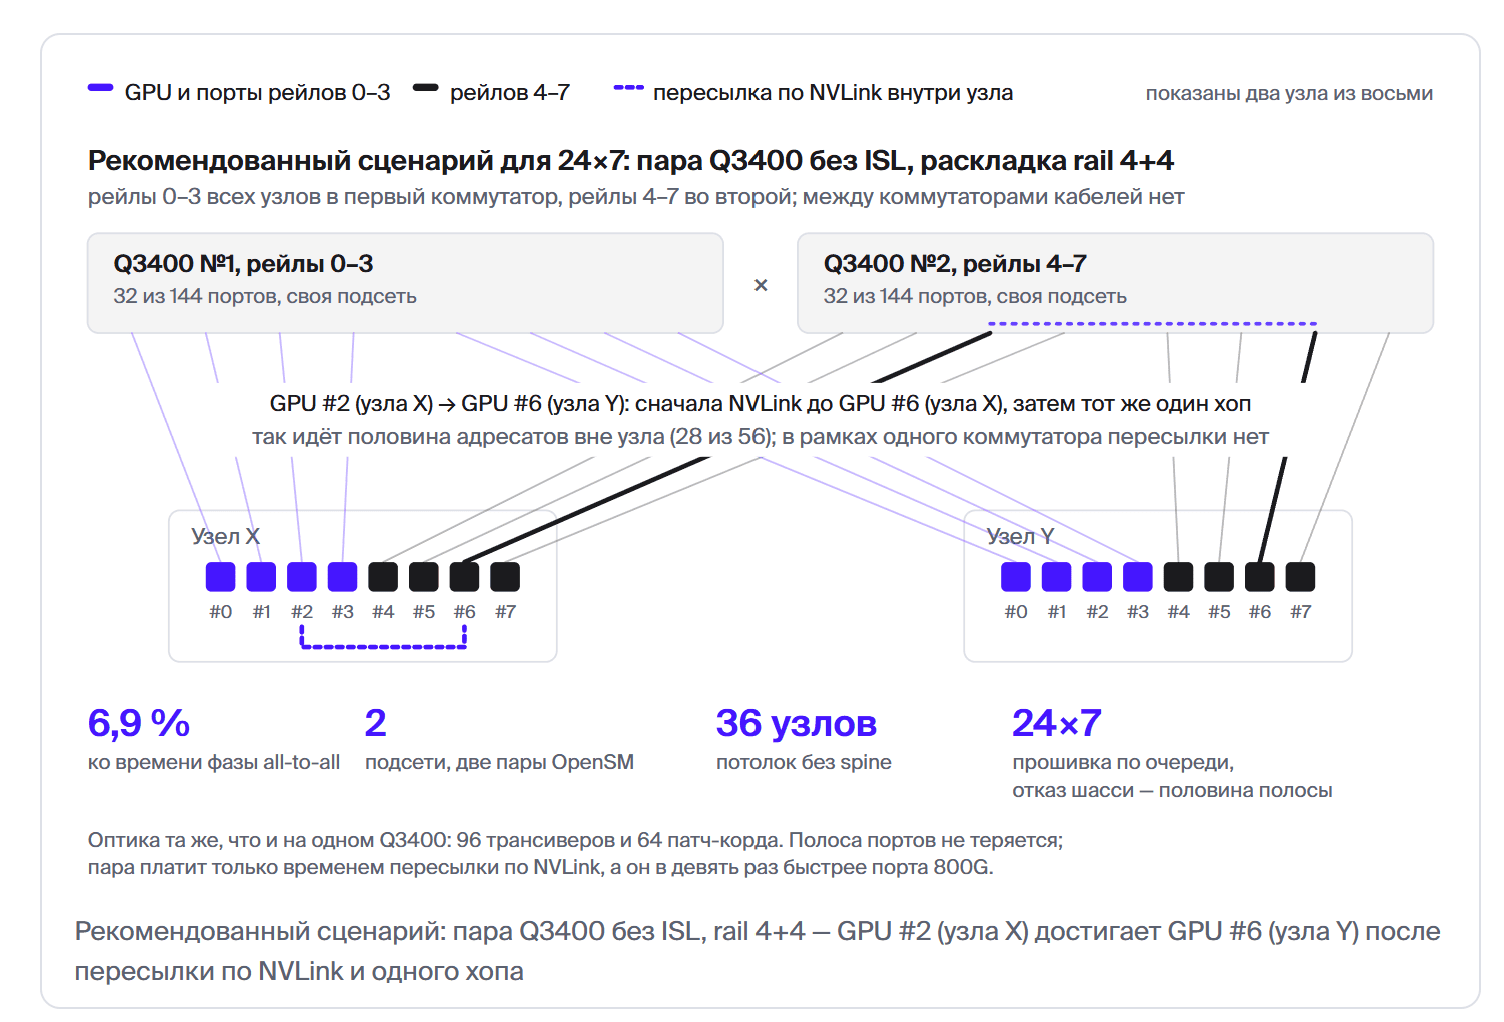
Цена пересылки по NVLink: 6,9 % на all-to-all. Полоса портов не теряется - каждый порт несёт те же 56 передач, что и в неблокируемом дереве, переподписки нет. Добавляется только время прохода по NVLink, а NVLink 5 в одну сторону в девять раз быстрее порта 800G: 900 против 100 ГБ/с. По формуле из работы «Rail-only» (MIT, 2024) это даёт 6,9 % ко времени фазы all-to-all против нуля на одном коммутаторе. Это расчёт при равномерной нагрузке экспертов, а не замер, и относится он к одной фазе, а не к запросу целиком; на пилоте он закрывается двумя замерами — alltoall_perf из nccl-tests и токенами в секунду на целевой модели. С этой ценой — 6,9 % и две подсети — дальше и сравниваются два сценария.
4. Стартовый сценарий: один Quantum-X800 Q3400 - просто, быстро, с окнами обслуживания
Если проект стартует с минимума, фабрика собирается на одном Q3400: все восемь рейлов всех узлов в один ASIC, 64 порта из 144. Это самый простой вариант и в закупке, и в эксплуатации: одна InfiniBand-подсеть, одна пара OpenSM (master и standby), SHARP по всей фабрике, ноль замедления на all-to-all, и любой GPU достаёт любой за один хоп, без пересылки внутри узла. Оптика та же, что и в любом другом сценарии: 32 твин-портовых модуля на разъёмы коммутатора, 64 одиночных на узлы, 64 патч-корда. Пустующие на старте 80 портов — оплаченный потолок в 18 узлов без перекоммутации.
| Параметр | Один Q3400, все рейлы в один ASIC | Пара Q3400 без ISL, rail 4+4 |
|---|---|---|
| Ведомость оптики | 96 модулей и 64 корда | та же |
| InfiniBand-подсетей | 1 | 2 |
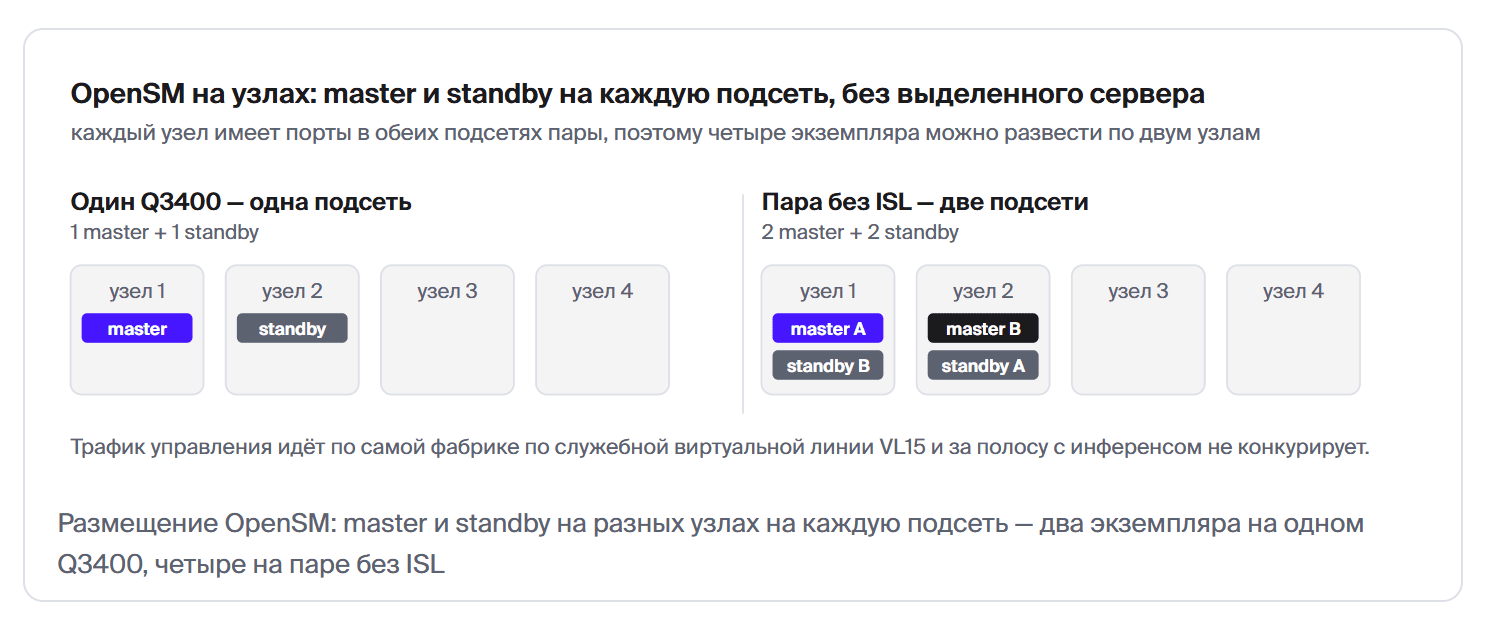
| Экземпляров OpenSM: master + standby | 1 + 1 | 2 + 2 |
| SHARP | по всей фабрике | в рамках одного коммутатора |
| Замедление all-to-all | нет | 6,9 % |
| Отказ шасси | фабрика встала | остаётся половина полосы |
| Обновление прошивки | вся фабрика, нужно окно | по очереди, кластер работает |
| Потолок узлов | 18 | 36 |
У одного коммутатора единственное, но решающее ограничение: он один. Обновление NVOS останавливает всю фабрику, а с ней и инференс, а отказ шасси - простой до замены. Поэтому стартовый сценарий подходит там, где регламент допускает плановые окна: пилот, внутренняя команда, ассистент без SLA на доступность. Хорошая новость в том, что переход к паре не требует ни одного нового трансивера: докупается второй Q3400, и половина твин-портовых модулей вместе с кордами рейлов 4–7 переезжает в него. Но переезд - это перекоммутация половины фабрики на работающем кластере, и если работа 24×7 стоит в планах, дешевле начинать сразу с пары.
5. Рекомендованный сценарий для 24×7: пара Q3400 без ISL и когда всё-таки нужен Fat Tree
Если инференс обслуживает сервис, который работает 24×7, фабрика собирается на паре Q3400. По железу коммутации это вдвое дороже стартового сценария, и это наша рекомендация для продуктива: только пара переживает отказ шасси и обновляется на ходу, прошивка накатывается по очереди, пока кластер работает на половине полосы.
Собирается пара двумя способами, и различаются они одним решением, есть ли межкоммутаторные линки.
Без ISL раскладка rail 4+4 из раздела 3: рейлы 0–3 всех узлов в первый Q3400, рейлы 4–7 во второй. Ведомость оптики не меняется ни на модуль: те же 96 трансиверов и 64 корда, по 16 твин-портовых модулей на коммутатор. Фабрика платит уже посчитанные 6,9 % на фазе all-to-all и живёт двумя подсетями, зато потолок роста - 36 узлов: каждый узел отдаёт коммутатору всего 4 линка.
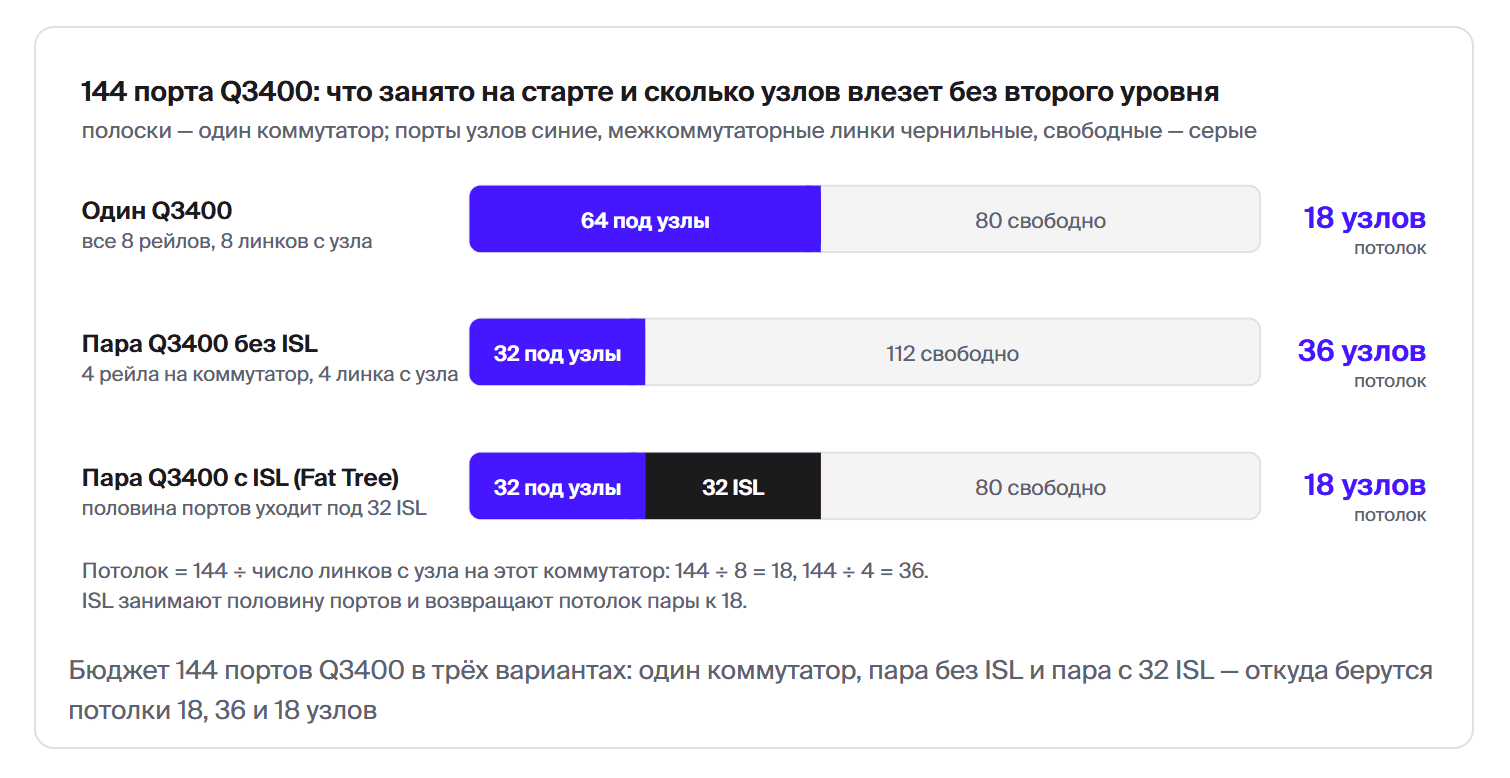
С ISL - классическое Fat Tree: 32 межкоммутаторных линка, и любая пара GPU оказывается в одной подсети с гарантированным any-to-any. Замедление исчезает, SHARP работает по всей фабрике, adaptive routing получает 32 пути для балансировки. Запас добавляет к базовой ведомости 32 твин-портовых модуля и 32 корда - и срезает потолок: половина портов каждого коммутатора уходит под ISL, так что фабрика растёт лишь до 18 узлов.
| Параметр | Пара Q3400 без ISL | Пара Q3400 с 32 ISL (Fat Tree) |
|---|---|---|
| Ведомость оптики | 96 модулей и 64 корда | 128 модулей и 96 кордов |
| InfiniBand-подсетей | 2 | 1 |
| Замедление all-to-all | 6,9 % | нет |
| SHARP | в рамках одного коммутатора | по всей фабрике |
| Отказ шасси | остаётся половина полосы | остаётся половина полосы |
| Обновление прошивки | по очереди, кластер работает | по очереди, кластер работает |
| Потолок узлов | 36 | 18 |
Нужны ли ISL инференсу? Нет, и это считается, а не декларируется. Главный межузловой поток инференса MoE, all-to-all экспертов, при рейл-раскладке либо идёт в рамках одного коммутатора за один хоп, либо доезжает по NVLink до GPU нужного rail (PXN из раздела 3) и дальше проходит тем же одним хопом. Между коммутаторами этому трафику ходить незачем, а плата за рейл-раскладку уже посчитана: 6,9 % ко времени одной фазы. ISL - это запас на другую жизнь кластера: дообучение, произвольные раскладки задач, сильный дисбаланс экспертов, при котором any-to-any даёт планировщику свободу. Наша рекомендация в типовом проекте: собирать без ISL, а запас добавлять не «на всякий случай», а под названную будущую нагрузку - тогда в ведомость осознанно доливаются 32 модуля и 32 корда.
В программу приёмки пары идут два пункта: гашение одного коммутатора на живой нагрузке с замером просадки токенов в секунду и возврат коммутатора с проверкой, что топология поднялась полностью, а не частично, - коллективные библиотеки по-разному переживают потерю половины сетевых карт.
6. Кто управляет фабрикой: OpenSM на узлах HGX вместо выделенного сервера
В типовом проекте на восемь узлов фабрикой управляет OpenSM, запущенный на самих узлах HGX, - выделенный сервер и UFM не нужны. InfiniBand не работает без subnet manager, а коммутаторы Quantum-X800 встроенного менеджера не несут - он всегда внешний: либо UFM, либо OpenSM на хосте с портом в фабрике. Сетевые карты на узлах уже стоят, отдельный управляющий сервер и его оптика в спецификацию не входят. Трафик управления идёт по самой фабрике по служебной виртуальной линии VL15 и с инференсом за полосу не конкурирует. На одну подсеть достаточно двух экземпляров - master и standby с меньшим приоритетом, обязательно на разных узлах; раскладка 4+4 удваивает конструкцию, по паре на каждую подсеть, и партиции с маршрутизацией настраиваются дважды и сравниваются диффом.
Чего OpenSM не даёт - телеметрии, веб-интерфейса и аналитики. Для восьми узлов это приемлемо, и решение обратимо: под UFM у Q3400 есть отдельный разъём fabric management, который портов фабрики не отнимает. На сентябрь 2026 года валидированная конфигурация платформы - NVOS 25.02.7002, прошивка ConnectX-8 40.48.1132, DOCA-OFED 3.3.0, OpenSM 5.26.1, HPC-X 2.26.0; сам факт, что OpenSM в наборе указан, подтверждает: менеджер на хосте для XDR штатен, а не самоделка.
7. Сервисные сети кластера: storage, in-band и out-of-band
Кроме compute-фабрики в кластере по логике NVIDIA SuperPOD есть ещё три сети, и все четыре физически раздельны — ни одна не делит коммутаторы с другой (RA-11339-001). Коротко об их назначении:
- Storage - доступ узлов к весам моделей, RAG-корпусу и офлоаду KV-кэша. Ethernet с RDMA, типично 2 × 100G или 2 × 400G на узел.
- In-band management - ОС узлов, провижининг, телеметрия, оркестрация инференс-стека. Типично 25G на узел.
- Out-of-band - BMC и удалённое управление оборудованием. Медная сеть, в расчёт оптики не входит.
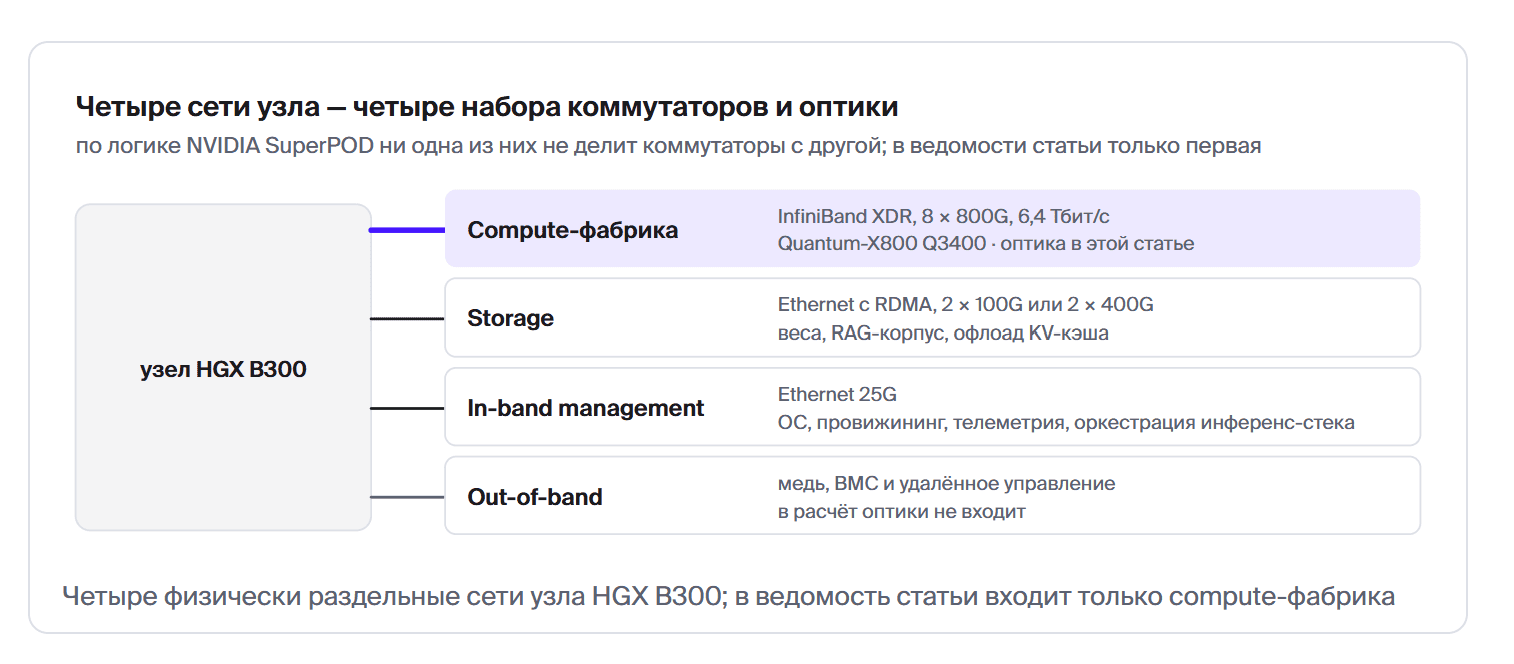
Эти три сети в типовом проекте вариативны, и это нормально: у интеграторов свои наработанные стеки, у заказчиков корпоративные стандарты на коммутаторы и мониторинг, поэтому сервисные сети собираются на том, что принято в парке. Фиксировать их в типовом проекте не нужно: совместимые модули ITPOD есть под все популярные коммутаторы - Cisco, Juniper, Arista, Huawei и другие - и на все ходовые скорости: ITPOD-SFP-25GSR, ITPOD-QSFP-100SR4, ITPOD-QSFP-400DR4. Оптика там считается классическим правилом «линк - это два трансивера и один патч-корд». В ведомости этой статьи они не входят: она про compute-фабрику.
8. Оптика 800G: чем модуль для сетевой карты (flat top RHS) отличается от модуля для коммутатора (finned top)
На 800G трансивер перестаёт быть расходником, который просто вставляют в порт. Твин-портовый модуль 1.6T рассеивает до 33,5 Вт - уровень небольшого процессора, - и охлаждение становится частью конструкции самого модуля. Самое интересное здесь в том, что коммутатор compute-фабрики и сетевая карта ИИ-сервера решают эту задачу противоположными способами. Поэтому один стандарт OSFP живёт в двух термоисполнениях, и менять их местами нельзя.
Finned top - для коммутатора. Ребристый радиатор выполнен прямо на верхней крышке модуля. Клетки OSFP у Quantum-X800 продуваются насквозь, рёбра стоят в этом потоке, и модуль снимает своё тепло сам - на коммутаторных клетках прижимных радиаторов нет.
Flat top в исполнении RHS - для сетевой карты. Крышка модуля плоская, а тепло с неё снимает прижимной радиатор (riding heatsink), закреплённый поверх интерфейсов самой сетевой карты. У ConnectX-8 в узлах HGX интерфейсы именно такие, поэтому туда идёт только плоский вариант.
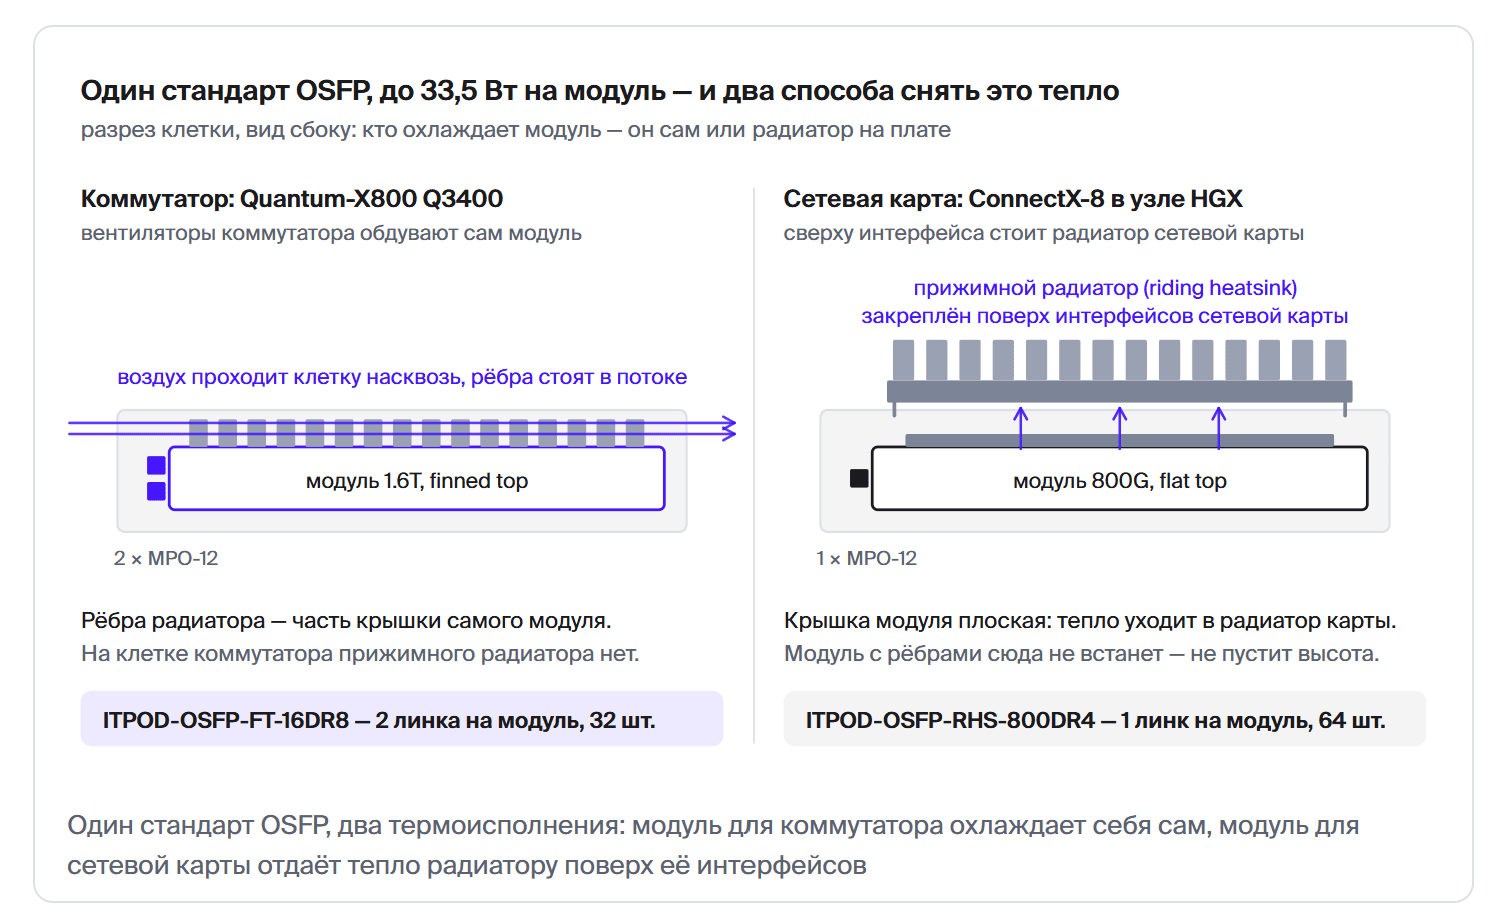
Как ошибаются с термоисполнением. Модуль с рёбрами в интерфейс сетевой карты физически не встанет: не пустит высота, ошибка ловится на монтаже. А плоский модуль в коммутатор встанет свободно, поднимет линк и останется без расчётного теплосъёма: рёбер у него нет, радиатора в коммутаторе тоже. Такая ошибка живёт в спецификации до первой серьёзной нагрузки, поэтому термоисполнение проверяется на этапе ведомости, а не на монтаже. В номенклатуре ITPOD оно зашито прямо в парт-номер: суффикс FT — finned top, RHS — flat top под прижимной радиатор.
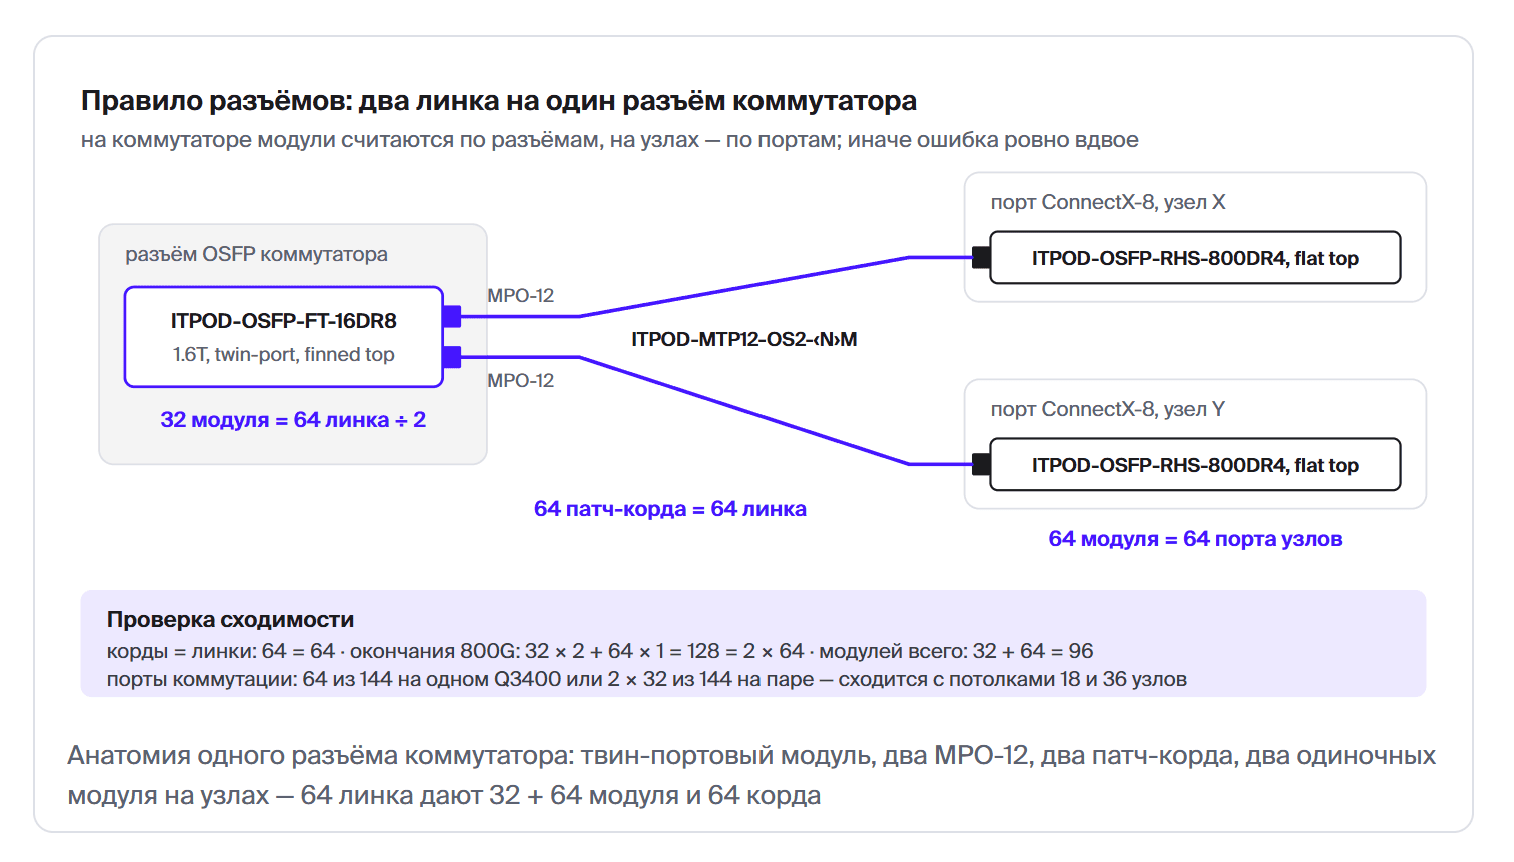
Правило разъёмов. Считать линки и считать модули — не одно и то же, и на 800G это расходится вдвое. Разъём OSFP на коммутаторе несёт твин-портовый модуль 1.6T с двумя разъёмами MPO-12 и обслуживает два линка по 800G; на стороне узла в порт ConnectX-8 идёт одиночный модуль 800G. Значит, на коммутаторе модули считаются по разъёмам, а на узлах — по портам. Медные DAC и активные AOC в расчёте не участвуют: фабрика держит единый оптический стандарт ради одного пула ЗИП.
| Парт-номер | Что это | Где стоит | Линков на модуль |
|---|---|---|---|
| ITPOD-OSFP-FT-16DR8 | 1.6T XDR OSFP224 2×DR4, два MPO-12, SMF 1310 нм, 500 м, finned top | разъёмы коммутатора | 2 |
| ITPOD-OSFP-RHS-800DR4 | 800G XDR OSFP224 DR4, MPO-12, SMF 1310 нм, 500 м, flat top (RHS) | порты ConnectX-8 в узлах HGX | 1 |
| ITPOD-MTP12-OS2-<N>M | патч-корд MTP-MTP, 12 волокон, SMF OS2, type B | один корд на линк 800G | — |
Это та же оптика, что стоит в наших отгруженных кластерах и СХД; эквивалентность модулям NVIDIA сверена по док-листам — ссылки в конце статьи. И две ошибки спецификаций вдобавок к термоисполнению. Первая: одиночные модули, посчитанные на разъёмы коммутатора вместо твин-портовых, — портов «не хватит» ровно вдвое. Вторая: модуль прошлого поколения ITPOD-OSFP-FT-800DR4 — это NDR под коммутаторы Quantum-2 (QM9700), и в проекте на Quantum-X800 он не применяется.
9. Сколько трансиверов и патч-кордов нужно на 8 узлов HGX B300: ведомости по парт-номерам
На 8 узлов HGX B300 нужно 96 трансиверов и 64 патч-корда — в любом сценарии без ISL. Расчёт короткий, потому что фабрика одноуровневая: 64 линка GPU ↔ коммутатор, на стороне узлов 64 одиночных модуля, на стороне коммутации 64 ÷ 2 = 32 твин-портовых, патч-кордов 64. Дальше — две ведомости под два сценария из разделов 4 и 5.
Один Q3400 (все рейлы в один ASIC):
| Парт-номер | Роль | Кол-во |
|---|---|---|
| ITPOD-OSFP-FT-16DR8 | 1.6T twin-port, 32 разъёма из 72 | 32 |
| ITPOD-OSFP-RHS-800DR4 | 800G, ConnectX-8 в узлах HGX | 64 |
Итого модулей | 96 | |
| ITPOD-MTP12-OS2-<N>M | патч-корд MTP-12 SMF, по одному на линк | 64 |
Пара Q3400 без ISL (rail 4+4 по коммутаторам):
| Парт-номер | Роль | Кол-во | На коммутатор |
|---|---|---|---|
| ITPOD-OSFP-FT-16DR8 | 1.6T twin-port, 16 разъёмов из 72 в каждом коммутаторе | 32 | 16 |
| ITPOD-OSFP-RHS-800DR4 | 800G, ConnectX-8 в узлах HGX | 64 | — |
Итого модулей | 96 | ||
| ITPOD-MTP12-OS2-<N>M | патч-корд MTP-12 SMF, по одному на линк | 64 | 32 |
| Опция ISL под Fat Tree | + ITPOD-OSFP-FT-16DR8 и + ITPOD-MTP12-OS2-<N>M | +32 и +32 | +16 |
Итоговые количества обоих сценариев совпадают до позиции (96 модулей и 64 корда), потому что узловая сторона не зависит от числа коммутаторов, а межкоммутаторных линков нет ни там, ни там. Различие только в раскладке твин-портовых модулей по коммутаторам и в строке-опции: Fat Tree добавляет 32 модуля и 32 корда.
Проверка сходимости - привычка, которая ловит ошибки до монтажа:
- патч-корды = линки: 64 = 64 - сходится;
- окончания 800G: 32 твин-порта × 2 MPO + 64 × 1 MPO = 128 = 2 × 64 линка - сходится;
- порты: один Q3400 - 64 из 144; пара - по 32 из 144 в каждом коммутаторе. Сходится с потолками 18 и 36 узлов;
- опция ISL: 32 линка × 2 конца ÷ 2 линка на модуль = 32 модуля, по 16 на коммутатор - сходится;
- контрольная сумма Fat Tree: 96 + 32 = 128 модулей и 64 + 32 = 96 кордов - сходится.
Длина корда зашита в суффикс парт-номера: -3M, -5M, -10M. Одноуровневая фабрика упрощает и это: все 64 компьют-линка сходятся в одну сетевую стойку, поэтому разброс длин определяется только расстоянием от стойки узла до сетевой - окончательная разбивка фиксируется после трассировки.
10. Питание и размещение Q3400: что учесть при монтаже
Паспортные числа Q3400-RA: 4U, 60 кг, восемь блоков питания, потребление 2 900 Вт типовое с пассивными кабелями и 7 000 Вт максимальное с активными. Разброс больше чем двукратный, поэтому стойка планируется не по типовому числу: оптика - основная переменная, твин-портовый модуль 1.6T берёт до 33,5 Вт, и 32 модуля фабрики добавляют до 1,1 кВт сверх собственного потребления коммутации. Для пары коммутаторов ввод и юниты считаются на два шасси в разных стойках или как минимум на разных лучах питания - иначе теряется главное, ради чего пара покупалась.
Продув у XDR-коммутаторов единственный: воздух входит со стороны разъёмов и выходит к блокам питания, значит в стойке коммутатор ставится портами в холодный коридор - совместить это с раскладкой узлов надо на плане машзала, а не на монтаже. И дисциплина передней панели: десятки MPO-12 на коммутатор требуют кассет и кабельных лотков, спланированных заранее, с маркировкой рейлов на этапе монтажа, иначе она делается при разборе первого инцидента.
11. Потолок роста: 18 узлов на одном Q3400 и 36 на паре без второго уровня
Арифметика потолков помещается в одну строку. Один Q3400: 144 порта ÷ 8 линков с узла = 18 узлов. Пара Q3400 без ISL: узел отдаёт каждому коммутатору по 4 линка, 144 ÷ 4 = 36 узлов. Пара с ISL - 18: половина портов занята межкоммутаторными линками, запас any-to-any куплен потолком. Расширение в этих пределах - только оптика и корды на новые узлы, без перекоммутации и остановки кластера.
За пределами одноуровневой фабрики начинается leaf-spine по референсной архитектуре SuperPOD - 8 leaf на scalable unit из 72 узлов плюс слой spine, и оптики на компьют становится вдвое больше: каждый линк узла дублируется линком leaf–spine. Для типового корпоративного инференса на 8–16 узлов этот масштаб - ориентир на будущее, а не стартовая точка.
12. Четыре вопроса заказчику до спецификации
Достаточность фабрики - не свойство коммутатора, а совпадение его свойств с профилем нагрузки. Поэтому перед тем, как ведомость уйдёт в закупку, заказчику задаются четыре вопроса.
- Сколько узлов будет через два года? До 18 узлов хватает одного Q3400, до 36 - пары без ISL, а дальше сразу проектируется leaf-spine.
- Допускает ли регламент плановые окна с остановкой инференса? На одном коммутаторе обновление прошивки останавливает всю фабрику, а отказ шасси - тем более. Если кластер работает 24×7, минимум два коммутатора.
- Будет ли кластер жить дольше задачи инференса? Дообучение, произвольные раскладки задач, единая подсеть с SHARP по всей фабрике - аргументы за ISL и Fat Tree, несмотря на дополнительную оптику и потолок 18.
- Насколько ровно модель нагружает экспертов? Расчётные 6,9 % раскладки 4+4 относятся к равномерному all-to-all. При горячих экспертах узкое место смещается на дисбаланс, и any-to-any даёт планировщику больше свободы ещё один голос за ISL.
13. Итоги: скелет типового проекта ИИ-кластера на 8 узлов
В типовом проекте фабрика на 8 узлов HGX B300 собирается одноуровневой, без spine и без межкоммутаторных линков, и выбор в ней устроен проще, чем кажется по каталогу.
- Оптика не участвует в выборе коммутатора. Ведомость одинакова во всех сценариях без ISL: 96 модулей ITPOD и 64 патч-корда. Экономия и рост живут в строке «коммутаторы», а не «трансиверы».
- Для старта - один Q3400. Ноль замедления, одна подсеть, SHARP по всей фабрике, потолок 18 узлов и самая простая эксплуатация ценой плановых окон: прошивка и отказ шасси останавливают всю фабрику.
- Для продуктива 24×7 - пара Q3400 без ISL, и это рекомендация. Та же оптика, отказ шасси на половине полосы, прошивка по очереди, потолок 36 узлов. Платой идут две подсети и 6,9 % на фазе all-to-all — и оба числа посчитаны, а не приняты на веру.
- ISL — осознанный запас, а не страховка по умолчанию. Инференсу any-to-any не нужен; Fat Tree добавляет 32 модуля и 32 корда и снижает потолок пары до 18 узлов. Добавлять его стоит под названную будущую нагрузку: дообучение, произвольные задачи, горячие эксперты.
Это и есть скелет типового проекта корпоративного ИИ-кластера: узлы выбираются по памяти и делимости экспертов, число коммутаторов — по регламенту эксплуатации и потолку роста, оптика считается правилом разъёмов, с правильным термоисполнением и проверкой сходимости до монтажа, а не после.
Частые вопросы
Сколько трансиверов нужно на кластер из 8 узлов HGX B300 с фабрикой 800G?
96: 64 одиночных модуля 800G в порты ConnectX-8 на узлах и 32 твин-портовых модуля 1.6T в разъёмы коммутатора, плюс 64 патч-корда MTP-12. Число не зависит от того, один коммутатор Q3400 или два без ISL.
Почему на коммутаторе модулей вдвое меньше, чем портов?
Каждый разъём OSFP Quantum-X800 несёт твин-портовый модуль 1.6T на два линка 800G. У Q3400-RA 144 порта и 72 разъёма под данные. Спецификация, посчитанная по портам, ошибается ровно вдвое.
Сколько узлов HGX B300 вытянет один Quantum-X800 Q3400?
18: 144 порта ÷ 8 линков с узла. Пара Q3400 без ISL - 36 узлов, потому что каждый узел отдаёт коммутатору только 4 линка. Пара с 32 ISL - снова 18.
Нужны ли межкоммутаторные линки (ISL) для инференса MoE-моделей?
Нет. Главный межузловой поток - all-to-all экспертов — при rail-раскладке идёт за один хоп в рамках одного коммутатора или после пересылки по NVLink внутри узла. ISL нужны под дообучение, произвольные раскладки задач и сильный дисбаланс экспертов.
Сколько теряет инференс на паре коммутаторов без ISL?
Расчётные 6,9 % ко времени фазы all-to-all при равномерной нагрузке экспертов (формула из работы Rail-only, MIT). Полоса портов не теряется, добавляется только время пересылки по NVLink, который в девять раз быстрее порта 800G.
Чем finned top отличается от flat top (RHS) и можно ли их менять местами?
Finned top несёт радиатор на крышке и ставится в продуваемые клетки коммутатора; flat top плоский и отдаёт тепло прижимному радиатору, закреплённому поверх интерфейсов сетевой карты. Модуль с рёбрами в сетевую карту не встанет физически, а плоский в коммутатор встанет и останется без теплосъёма при 33,5 Вт. Менять местами нельзя.
Подходят ли NDR-модули 800G от Quantum-2 (QM9700) для Quantum-X800?
Нет. Для XDR нужны модули OSFP224: ITPOD-OSFP-FT-16DR8 на коммутатор и ITPOD-OSFP-RHS-800DR4 на узлы. NDR-модуль ITPOD-OSFP-FT-800DR4 в этом проекте не применяется.
Нужен ли UFM или выделенный сервер управления фабрикой?
Для восьми узлов - нет. Коммутаторы Quantum-X800 встроенного subnet manager не несут, но OpenSM штатно запускается на узлах HGX: master и standby на разных узлах, по паре на каждую подсеть. UFM добавляется позже через отдельный разъём fabric management, не отнимая портов фабрики.
Источники расчётов и спецификации
Каждое нормативное число в статье взято из документа, а не из общих представлений о том, как устроены ИИ-кластеры.
- NVIDIA SuperPOD with DGX B300 Systems, Quantum-X800 InfiniBand and AC Power (RA-11339-001 V01 от 23.07.2025) — полоса на узел и блокировка 1:1, принцип rail-optimized full-fat-tree, четыре раздельные сети кластера.
- Даташит NVIDIA Quantum-X800 InfiniBand Switches — radix Q3400-RA, группы разъёмов OSFP.
- NVIDIA XDR InfiniBand Switches Hardware User Manual (семейство Q34xx) — порты и разъёмы, отдельный разъём fabric management, блоки питания, продув, потребление.
- Validated configuration платформы Quantum-X800 - согласованный набор версий NVOS, прошивок, DOCA-OFED, OpenSM, HPC-X; подтверждение, что OpenSM на хосте - штатный вариант менеджера для XDR.
- Док-листы оптических модулей NVIDIA - параметры твин-портового 1.6T OSFP 2×DR4 (finned top, до 33,5 Вт) и одиночного 800G OSFP DR4 (flat top, RHS); по ним подтверждена эквивалентность позициям ITPOD-OSFP-FT-16DR8 и ITPOD-OSFP-RHS-800DR4.
- «Rail-only: A Low-Cost High-Performance Network for Training LLMs with Trillion Parameters» (arXiv 2307.12169, финальная редакция v5 от 15.09.2024) - формула замедления при пересылке через NVLink и опубликованный диапазон 8,2–11,2 %. Промежуточные редакции давали вдвое меньшие числа из-за двунаправленной полосы в знаменателе - цитировать стоит финальную.
- Блог NVIDIA о NCCL 2.12 - механизм PXN и каноническое определение rail-optimized: NIC-0 всех узлов в один leaf, NIC-1 - в следующий.
- Технический отчёт DeepSeek V4 и карточка Kimi K3 - параметры моделей и требования Expert Parallelism к межузловой полосе.