Односокетный сервер на AMD EPYC 9005: почему один процессор лучше двух
Почему односокетный сервер стал актуальным
Пока процессор давал 16 или 24 ядра, отказ от второго сокета означал отказ от половины вычислений на узел. Это отражалось и на сети: ту же ёмкость набирали вдвое большим числом узлов, каждый забирал пару портов доступа, а интерфейс на 10 или 25 Гбит/с стоял под нагрузкой в единицы гигабит.
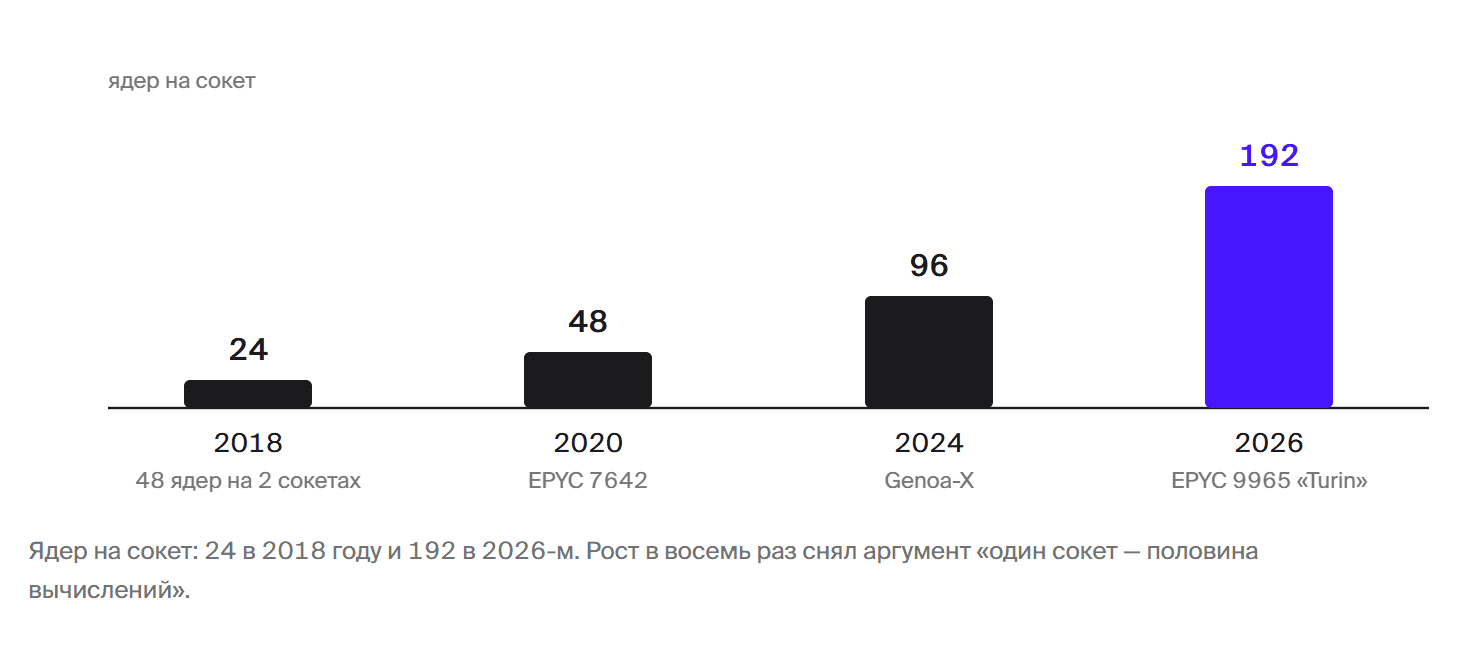
Вопрос решился путем увеличения плотности ядер. Один сокет EPYC 9005 содержит до 192 ядер и 12 каналов DDR5 при раскладке по одному модулю на канал - это больше, чем давала двухсокетная конфигурация двумя поколениями раньше. В поколении 2026 года у Cloudflare 12 модулей DDR5-6400 по 64 ГБ дают 614 ГБ/с на сокет, на 33,3 % больше предыдущего поколения, с требованием одинаковой ёмкости и ранговости по всем каналам.
Стоимость эксплуатации серверного парка
Проведем простые расчеты. Операция вручную длительностью двадцать минут раз в неделю на каждом из двухсот узлов оборачивается 66 часами в неделю. Это больше полутора ставок инженера на одну процедуру. Порог окупаемости автоматизации наступает не на сотой тысяче серверов, а когда операция начинает повторяться каждую неделю. Так считает и корпоративный ЦОД, и сервис-провайдер вроде ITGLOBAL.COM, который эксплуатирует собственный парк и продаёт его как услугу.
Устранение неполадок забирает время инженера. Сбой в работе сервера, который каждый раз начинается с чистого листа, превращается в сложную работу с перебором деталей, и инженеру приходится тратить кучу времени на поиск причин вместо работы над отказоустойчивостью приложений.
Что меняется при одном сокете в лучшую сторону
NUMA (Non-Uniform Memory Access) означает, что у каждого процессора своя локальная память, а путь до памяти соседа идёт через межсокетный интерконнект и возвращается тем же маршрутом.
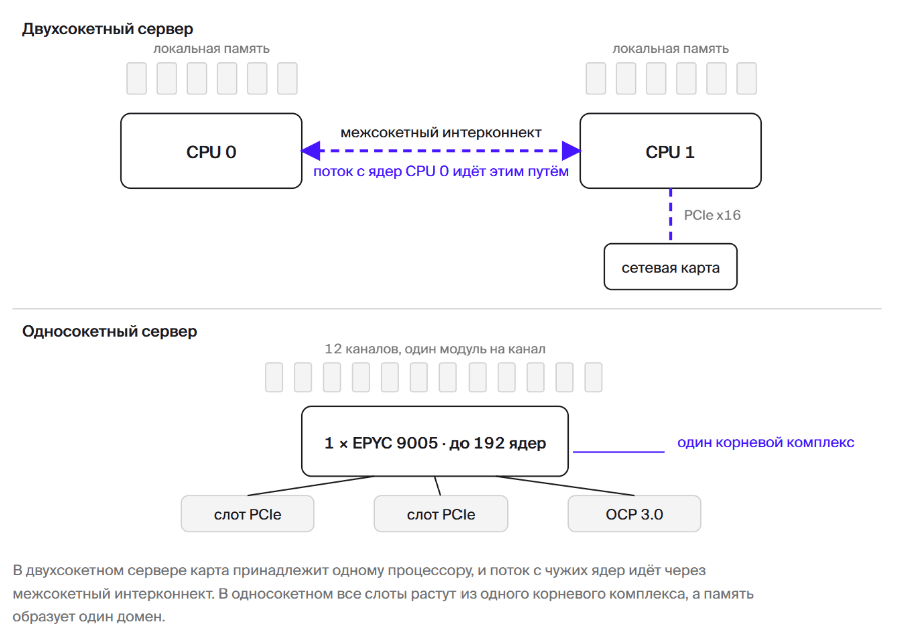
Память. Сбойный слот называет контроллер в любом сервере. Разница в том, что происходит дальше: в двухсокетном узле у плавающей ошибки появляется ответвление - модуль, контроллер конкретного процессора или маршрут нагрузки между доменами. При одном сокете хозяин у всех каналов один, а раскладка по одному модулю на канал делает связку «канал равен модулю» однозначной.
Линии PCIe. Карта отдаёт заявленную скорость, когда её обрабатывают ядра того же домена. Отсюда слой правил: слот выбирается под процессор, очереди карты и потоки приложения привязываются к ядрам её домена, балансировщик операционной системы ограничивается, а после любой перестановки карты привязку проверяют заново. В односокетном сервере вопрос исчезает вместе с предметом. Для DPI, анти-DDoS и любых нагрузок, где пакет обрабатывается на скорости линии, это разница между предсказуемым временем обработки и охотой за источником задержки.
Обслуживание односокетного сервера в ЦОД: короткая инструкция для инженера
Размер инструкции для инженера - такая же характеристика платформы, как число деталей. Один процессор, один радиатор, один воздуховод, одинаковые модули памяти: меньше шагов, меньше поводов перепутать позицию и задеть соседний узел. Склад получает короткую номенклатуру ЗИП и одну процедуру замены на весь парк.
Накопители, вентиляторы и блоки питания при резерве 1+1 меняются на горячую, без окна обслуживания. Остановки остаются для памяти и процессора, и они предсказуемы: узлы одинаковые, значит выпадает известная доля мощности парка, а не тот единственный сервер, на котором держится половина сервисов.
Мониторинг серверного парка: один сокет как единица сравнения
Один сокет равен одному серверу, поэтому все счётчики узла описывают один вычислительный домен, и график одного узла читается рядом с любым другим без оговорок.
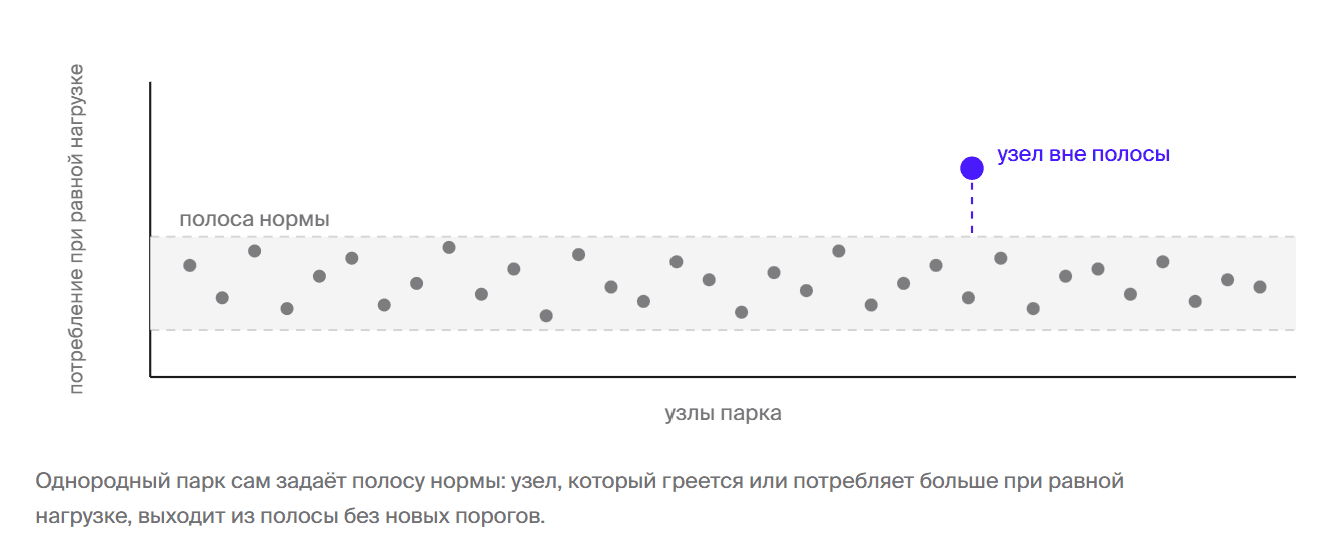
Сотня одинаковых узлов сама задаёт полосу нормы, и аномалия выходит из полосы без новых порогов и правил. Дальше полоса снимается по профилям нагрузки: гипервизор, реляционная база и узлы Kubernetes дают свои числа - сколько узел держит виртуальных машин при заданной переподписке, сколько транзакций до упора в память, сколько подов до упора в сеть. После этого парк планируется числами: под следующий проект берётся тот же узел в известном количестве.
Односокетные платформы в распределённых сервисах защиты от DDoS
Фильтрация трафика - предельный случай эксплуатации: точки присутствия по всему миру, постоянного персонала на площадках нет, пакет должен обрабатываться за предсказуемое время. Рассмотрим вопрос на примере успешного опыта мировых гигантов.
Cloudflare, крупный облачный провайдер, парк в 330+ городах. В 2020 году они поменяли подход: 48 ядер на одном AMD EPYC 7642 вместо 48 ядер на двух Intel Xeon Platinum 6162, TDP на ядро ниже на 25 %, базовая частота 2,4 против 1,9 ГГц. К двухсокетной базе лабораторные замеры дали до 36 % больше запросов, промах кэша L3 ниже примерно на 50 %, до двух раз лучший показатель Requests per Watt и задержку p99 в NGINX ниже на величину до 50 % - речь о времени обработки запроса на сервере. В продакшне платформа принесла +23 % запросов на процент загрузки CPU и +28 % запросов на ватт. Схему они держат шесть поколений подряд.
StormWall, восемь точек присутствия и более 8000 Гбит/с фильтрации. Сеть охватывает Майами, Лос-Анджелес, Франкфурт, Гонконг, Сингапур, Дубай, Софию и Джакарту; в 2026 году добавляются Бразилия, Индия и Казахстан. Команда пишет собственный программный комплекс фильтрации, и его экземпляр работает на односокетной платформе AMD: один сервер фильтрации в точке присутствия, единый домен памяти под таблицы состояний, полностью удалённое обслуживание.
Оба сервиса забирают производительность процессора, не платя за неё работой с NUMA, и обслуживают парк одинаково: узел выводят из работы, диагностируют удалённо, лечат заменой детали.
Развертывание и диагностика сервера по шаблону: Redfish, IPMI, PXE и UEFI
| Интерфейс | Что закрывает | Роль в шаблоне |
|---|---|---|
| Redfish | инвентарь, телеметрия, настройка узла и события по HTTP в JSON, ролевая модель | узел настраивается кодом, а не руками в веб-интерфейсе |
| IPMI | питание, консоль, совместимость со старым инструментарием | операции одной командой из скрипта |
| PXE | загрузочный образ по сети | точка, где развёртывание становится шаблонным |
| UEFI с Secure Boot | контроль того, что загружен положенный образ, сверка версии прошивки | доверенная база под шаблон |
Узел под гипервизор получает свои настройки BIOS, разметку и образ; узел под реляционную базу — другие настройки энергосбережения и другой образ. Оператор выбирает шаблон, дальше Ansible поверх Redfish выставляет параметры, PXE приносит образ, инвентарь и серийные номера уезжают в ITAM-систему тем же прогоном, телеметрия подхватывается мониторингом. Шаблонов столько, сколько ролей, а не сколько узлов.
Петля диагностики собирается из стандартных интерфейсов: канал управления даёт доступ до операционной системы, PXE приносит тест-образ, решение уходит в заявку машинно-читаемым.
Те же интерфейсы закрывают диагностику, и простой узел делает петлю дешевле: диагностическому образу не нужно различать, какая половина сервера виновата.
Отказ узла: что видит дежурный и что он делает
| Что отказало | Как это видно снаружи | Что делает дежурный |
|---|---|---|
| Накопитель | пропало присутствие в отсеке, растут ошибки или предиктивный признак | сверяет серийный номер, подсвечивает отсек, меняет на горячую, проверяет возврат тома в норму |
| Вентилятор | обороты вне порога, событие в журнале | меняет модуль на горячую, убеждается, что температуры вернулись к фоновым |
| Блок питания | событие в журнале, узел работает на парном блоке при резерве 1+1 | меняет блок на горячую, проверяет, что резерв восстановлен |
| Модуль памяти | корректируемые ошибки копятся на одном канале либо пришла некорректируемая | по корректируемым планирует окно, по некорректируемой выводит узел сразу; меняет один модуль и проверяет счётчик после прогона |
| Сетевая карта | линк, счётчики ошибок и отбросов на порту | проверяет трансивер и кабель, меняет карту в окно обслуживания, привязку потоков не пересобирает |
| Перегрев и троттлинг | температуры у порога, частота ниже номинала при штатной нагрузке | проверяет воздуховод, фильтры и температуру на входе, сверяет с соседями по стойке |
| Процессор | память, питание и накопители исключены, отказ повторяется на диагностическом образе | выводит узел, ставит процессор из ЗИП, возвращает нагрузку после чистого прогона |
| Узел не проходит POST | нет отклика от операционной системы, код или событие в журнале контроллера | снимает журнал, повторяет включение с диагностическим образом, эскалирует с доказательствами |
Первые три строчки - свойство шасси: горячая замена есть и у двухсокетных платформ, её проверяют отдельно. Разница появляется ниже. Там, где двухсокетный сервер требует ответить, какая половина виновата и чьи линии обслуживают карту, у односокетного этого вопроса нет.
Порядок работ одинаков для любой строки. Зафиксировать доказательства: журнал контроллера управления, серийный номер и позицию детали, время события. Заменить. Подтвердить по телеметрии, что показатель вернулся к фоновому. Обновить запись в ITAM-системе, для русских проектов это SimpleOne ITAM. Вернуть нагрузку. Пропущенный последний шаг - самая частая причина того, что через полгода никто не знает, что за диск стоит в отсеке.
Когда 192 ядра на сокет не хватает: два и четыре сокета
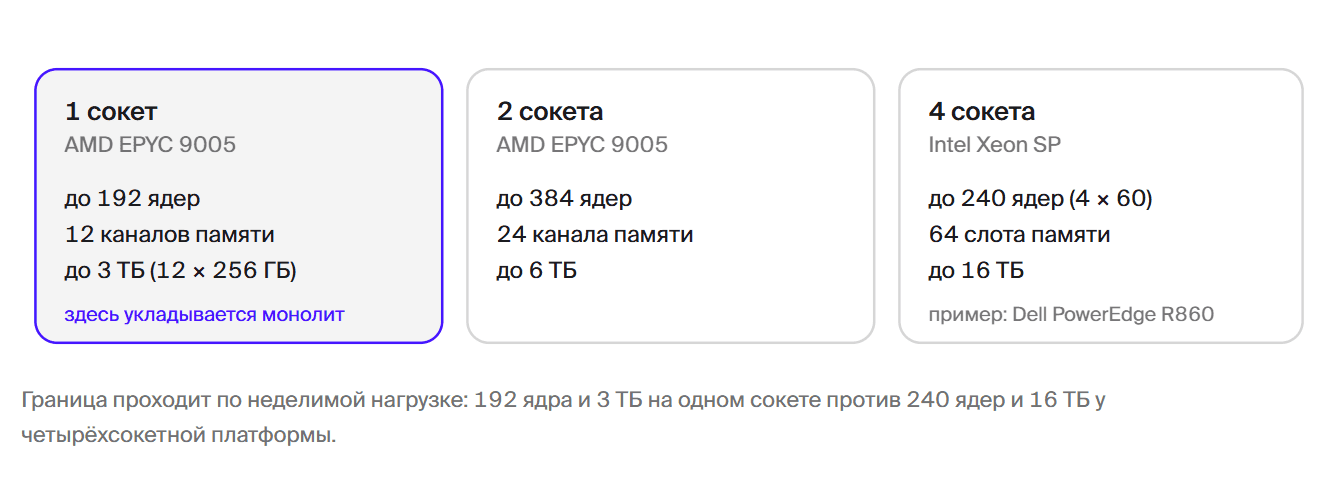
Граница проходит по неделимой нагрузке. Пока монолитное приложение укладывается в 192 ядра, 12 каналов памяти и 3 ТБ при модулях 256 ГБ, второй сокет только усложнит ситуацию , а не добавит производительность.
Как только монолиту нужно больше ядер или больше памяти в одном экземпляре операционной системы, разговор переходит к двум сокетам, а при серьёзных объёмах - сразу к четырёхсокетным платформам на Intel Xeon. Для порядка величин: Dell PowerEdge R860 содержит четыре процессора Intel Xeon SP четвёртого поколения по 60 ядер, 64 слота памяти и до 16 ТБ в одном узле. Такой сервер закрывает совсем другой класс задач - большая реляционная база, ин-мемори аналитика, консолидация того, что нельзя разрезать между узлами. Никакая односокетная платформа этого не заменит, и обратное утверждение было бы неправдой.